我的AFL++fuzzing入门之路(2)
00 前篇回顾
在笔者的上一篇,也是 AFL++ Fuzzing 系列的第一篇中,我们完成了以下工作:
理论基础:建立了对 AFL++ 的基础认知,包括其作为覆盖率引导模糊测试框架的定位、核心漏洞挖掘能力,以及编译时插桩的工作原理;
环境搭建:在 Ubuntu 24.04 虚拟机中完成了 AFL++ 的源码编译安装,解决了 Ubuntu Apport 与 core_pattern 的系统冲突;
实战入门:构造并测试了首个漏洞程序,在 2.7 秒内成功触发崩溃,同时掌握了 AFL++ 状态界面 8 区域的核心指标解读方法。
基于昨日的实践基础,本文将推进三个层面的深入探索:
插桩汇编表现:通过 IDA 反编译观察 AFL++ 使用 LLVM 的 SanitizerCoverage 在二进制层面插入的 inline 代码,理解 AFL++ 如何记录边覆盖率,从汇编指令级掌握覆盖率追踪的底层机制;
难度进阶:通过修改触发条件(从 “AFL++” 阶梯式扩展至平墙式),测试 AFL++ 的变异深度与效率边界,观察 havoc 策略在长模式匹配场景下的表现;
崩溃分析:引入 GDB 调试器对发现的崩溃进行根因定位,掌握调用栈回溯、寄存器状态检查等漏洞分析基础技能,完成从"发现崩溃"到"理解崩溃"的闭环。
01 汇编插桩
为了简单,咱直接素材复用,上一篇中的test.c使用afl-cc编译的,现在再用gcc编译一遍,然后放到不同的工具下比对
❯ cat test.c
#include <stdio.h>
#include <string.h>

int main(int argc, char *argv[]) {
    char buf[100];
    FILE *f = fopen(argv[1], "r");
    if (!f) return 1;
    fread(buf, 1, sizeof(buf), f);
    fclose(f);

    // 漏洞触发点:输入 "AFL++" 会崩溃
    if (buf[0] == 'A' && buf[1] == 'F' && buf[2] == 'L')
        if (buf[3] == '+')
            if (buf[4] == '+')
                __builtin_trap();  // 触发崩溃(SIGTRAP)
    return 0;
}

afl-cc -o test test.c
gcc -o test-gcc test.c
这里就得到了两个不同的可执行程序版本:有afl插桩的test和gcc编译的无插桩的test-gcc
我们由易到难用,工具来比对这两个版本
1st. 编译对比
简单直接,插桩添加的代码指令会导致程序比正常编译的程序更大
❯ ls -la test test-gcc
-rwxr-xr-x 1 root root 119968 Mar  9 00:06 test
-rwxr-xr-x 1 root root  16096 Mar  9 12:43 test-gcc
快速定位插桩符号,可以看到多出了很多以**__afl_**为前缀的函数
❯ strings test | grep -i afl | head -20
__afl_manual_init
__afl_coverage_interesting
__afl_auto_second
__afl_already_initialized_shm
__afl_prev_caller
__afl_persistent_loop
__afl_selective_coverage_start_off
__afl_selective_coverage
__afl_dictionary_len
__afl_connected
__afl_coverage_skip
__afl_fuzz_len
__afl_coverage_off
__afl_auto_init
__afl_prev_ctx
__afl_map_addr
__afl_area_ptr
__afl_coverage_on
__afl_auto_early
__afl_final_loc

❯ strings test-gcc | grep -i afl
2nd. 反汇编对比(核心重点)
执行以下命令,将两个程序的汇编代码输出出来比对main函数:
objdump -d test > test.asm
objdump -d test-gcc > test-gcc.asm
或者直接用ida看,图形化更直观:
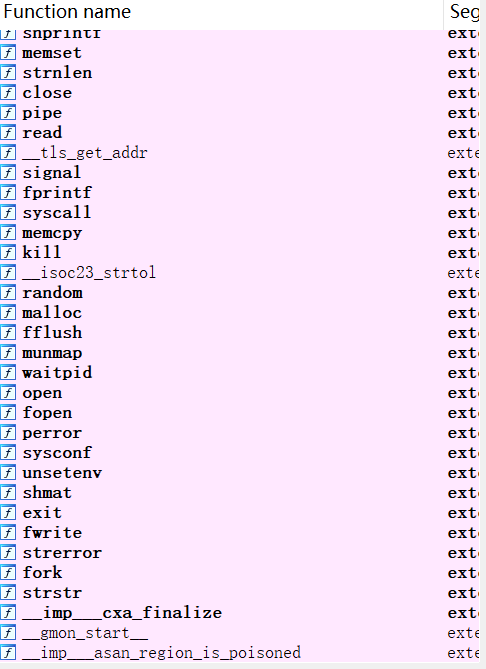
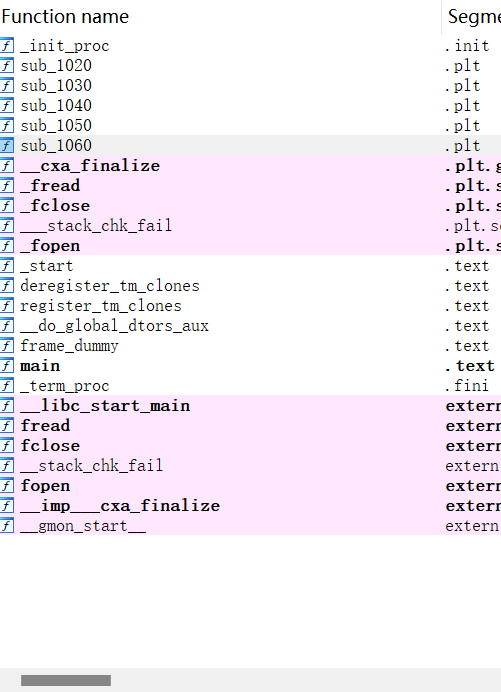
比如函数解析中,afl-cc版比gcc版多了很多系统函数
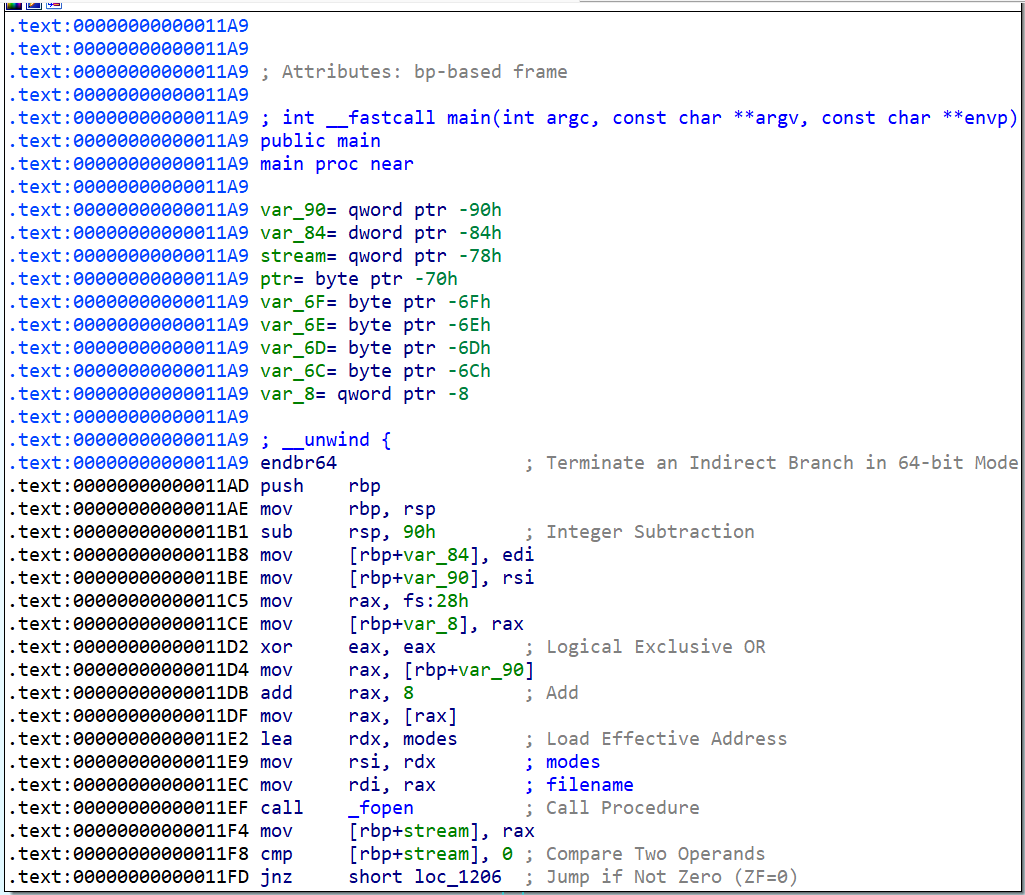
而这是gcc版的main函数开头,可以发现非常简洁
而这是afl-cc版的main函数开头
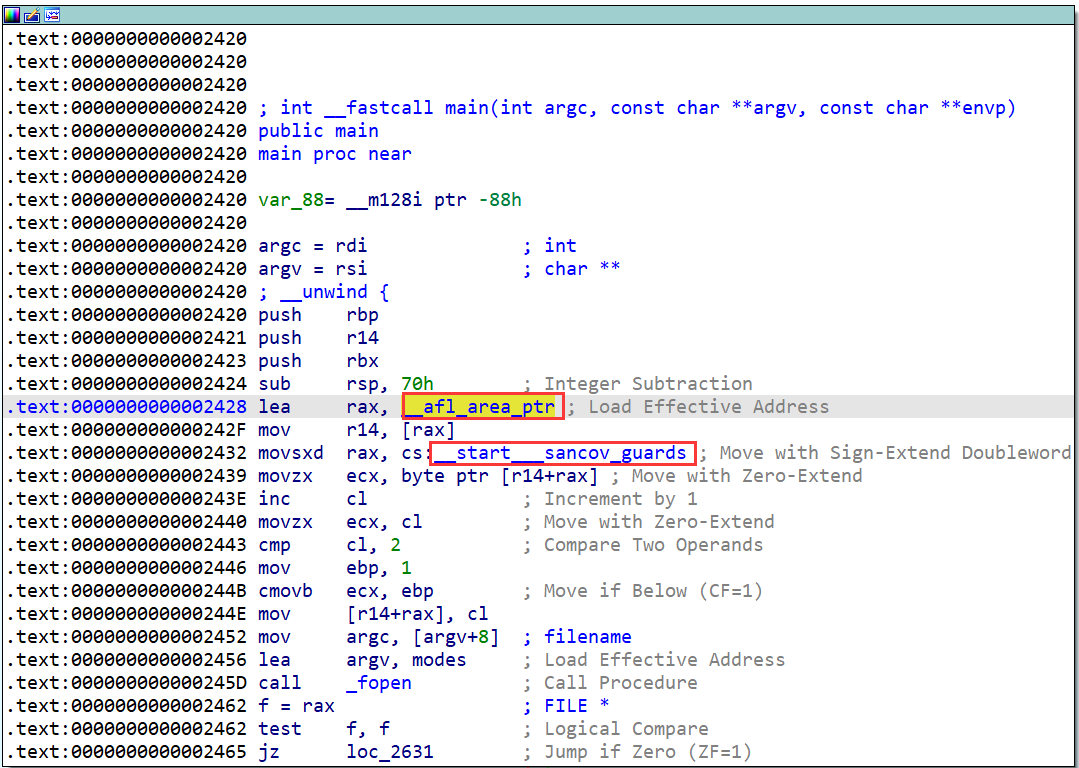
可以发现多了__afl_area_ptr 和 __start___sancov_guards这两个东西
__afl_area_ptr:共享内存 bitmap 基址,是 AFL 覆盖率地图的核心。__start___sancov_guards:LLVM SanitizerCoverage 的 guard 数组起始地址,用来给每条边编号。
guard 变量本身只是
uint32_t,真正编号是在模块构造函数__sanitizer_cov_trace_pc_guard_init里完成的:该函数遍历__start___sancov_guards到__stop___sancov_guards,把每个 guard 赋值为 1、2、3…,用来标识不同的边
它们的作用以及触发条件:
__afl_area_ptr:运行时会被 AFL++ 的afl-fuzz通过共享内存映射覆盖,指向 fuzzer 侧维护的 64KB bitmap。__start___sancov_guards里的 guard 变量:在模块初始化函数中被编号为 1、2、3…,用来标识不同的边。- 插桩代码以
guard 值为下标,访问__afl_area_ptr[offset],实现“边覆盖计数”。
3rd. 汇编代码解析
那么它们是怎么来的呢?
这是LLVM 模式的内联优化:与传统 AFL 的运行时调用 __afl_maybe_log 不同,LLVM 模式利用 SanitizerCoverage 直接在编译期将探针内联到代码中。观察汇编可见,覆盖率更新被优化为单条 inc 指令操作共享内存位图,消除了函数调用开销,同时保留了 NeverZero 溢出保护机制。
仔细看汇编后可以发现afl-cc版有一个比较明显的结构:
2428:	lea    0x8d59(%rip),%rax        # b188 <__afl_area_ptr>
242f:	mov    (%rax),%r14              # r14 = 位图基地址
2439:	movzbl (%r14,%rax,1),%ecx       # ecx = 当前边的计数
243e:	inc    %cl                      # 计数+1 (核心操作!)
2440:	movzbl %cl,%ecx
2443:	cmp    $0x2,%cl                 # 检查是否溢出
2446:	mov    $0x1,%ebp
244b:	cmovb  %ebp,%ecx                # 溢出保护 (NeverZero)
244e:	mov    %cl,(%r14,%rax,1)        # 写回位图
- NeverZero 的核心目标是:如果计数器 inc 之后会变为0( 即255 溢出时),把结果变成 1,避免 fuzzer 把这条边当成“没执行过。
- 对应到指令,就是你看到的
cmp $0x2+cmovb:如果结果是 0,就改成 1。 - 即,如果某个边的执行次数超过 255 次,也不会因为偶然溢出到 0 而被 fuzzer 忽略,从而提高路径发现的稳定性
02 插桩原理:SanitizerCoverage
1st.什么是插桩
插桩(instrumentation):在保证原程序逻辑完整性的情况下,在程序中插入一些代码来采集运行期间的执行状态。
最简单的插桩如下所示,可能很多师傅在写程序的时候用过:
不确定这个段代码会不会执行,print一下,
看看某个变量是不是达到了自己的预期值,print一下……
int test_var = 0;

// original (1)
void b() { ...; }
void a() { ...; }

// instrumented (2)
void b() { printf("test_var: %d\n", test_var); ...; }
void a() { printf("test_var: %d\n", test_var); ...; }
插桩的特点︰
插桩的对象通常都具有相同的属性或类别涉及所有的功能、所有的基本块,比较少针对单一目标。
插桩的程序代码通常只有几行汇编代码,并且不会做太复杂的操作。
在模糊器中,插桩被用来进行覆盖,那么记录多少程序码被执行到。
2nd.LLVM 模式 vs 传统 AFL
而至于AFL++的LLVM模式:
AFL++ 的 LLVM 模式并非摒弃插桩,而是采用了更先进的编译器级插桩方案。通过 LLVM 的 SanitizerCoverage 框架,在 IR 层插入覆盖率探针,并借助编译器优化内联为直接内存操作,消除了传统汇编插桩的函数调用开销。
关键优化:
- 无函数调用:直接
inc内存,比call __afl_maybe_log快 - NeverZero 补丁:
cmp $0x2+cmovb确保计数不会归零溢出 - 内联实现:LLVM 在编译期直接生成这些指令
SanitizerCoverage 作为 LLVM 的编译器级插桩框架,是 AFL++ 实现覆盖率追踪的核心机制。通过 IDA 反编译观察 AFL++ 在二进制层面内联插入的汇编代码(lea→mov→inc→cmovb 序列),理解其如何通过直接内存操作更新边覆盖率位图,从指令级掌握覆盖率追踪的底层实现——包括共享内存映射、NeverZero 溢出保护等关键技术细节。
这里主要对比的是 SanitizerCoverage 的 inline-8bit-counters 模式,它会在每个边缘插入内联的计数器增量,如下:
| 概念 | 传统 AFL | SanitizerCoverage |
|---|---|---|
| 代码形态 | Trampoline(跳板函数调用) | Inline(内联展开) |
| 指令特征 | call __afl_maybe_log | inc byte ptr [r14+rax] |
| 性能 | 有 call/ret 开销 | 无函数调用开销,仅有少量内存访问指令 |
补充1:传统的AFL插桩function add_instrumentation() 中对会对每个基本块做插桩,主要使用跳板函数__afl_maybe_log() ,这一块我就不多介绍,有兴趣的师傅可以搜搜相关的文章了解一下。
补充2:不是所有 LLVM 模式都一定有 __sancov_guards,LLVM模式还有很多种,只不过刚好SanitizerCoverage被AFL++借来用了
至此,我们简单的完成了对 AFL++ 插桩机制的底层观察。接下来通过增加触发难度,测试其变异策略的实际表现。
03 难度进阶:反馈机制的重要性
1.st 实验源码
咱把之前的test.c修改一下:
cat > test_step.c << 'EOF'
#include <stdio.h>
#include <string.h>

int main(int argc, char *argv[]) {
    char buf[100];
    FILE *f = fopen(argv[1], "r");
    if (!f) return 1;
    fread(buf, 1, sizeof(buf), f);
    fclose(f);

    // 阶梯式
    if (buf[0] == 'A')
        if (buf[1] == 'F')
            if (buf[2] == 'L')
                if (buf[3] == '+')
                    if (buf[4] == '+')
                        __builtin_trap();

    return 0;
}
EOF
再添加一个比对的:
cat > test_wall.c << 'EOF'
#include <stdio.h>
#include <string.h>

int main(int argc, char *argv[]) {
    char buf[100];
    FILE *f = fopen(argv[1], "r");
    if (!f) return 1;
    fread(buf, 1, sizeof(buf), f);
    fclose(f);

    // 平墙式
    if (memcmp(buf, "AFL++", 5) == 0)
        __builtin_trap();
    return 0;
}
EOF
我们来看看AFL++在这两个程序上的表现
afl-cc -o test_step test_step.c
afl-cc -o test_wall test_wall.c

# 接着用无意义的垃圾数据做种子
❯ mkdir -p step_out wall_out
echo "test" > in/seed.txt

afl-fuzz -i in -o out -- ./test_step @@
afl-fuzz -i in -o out -- ./test_wall @@
2nd. fuzzing结果
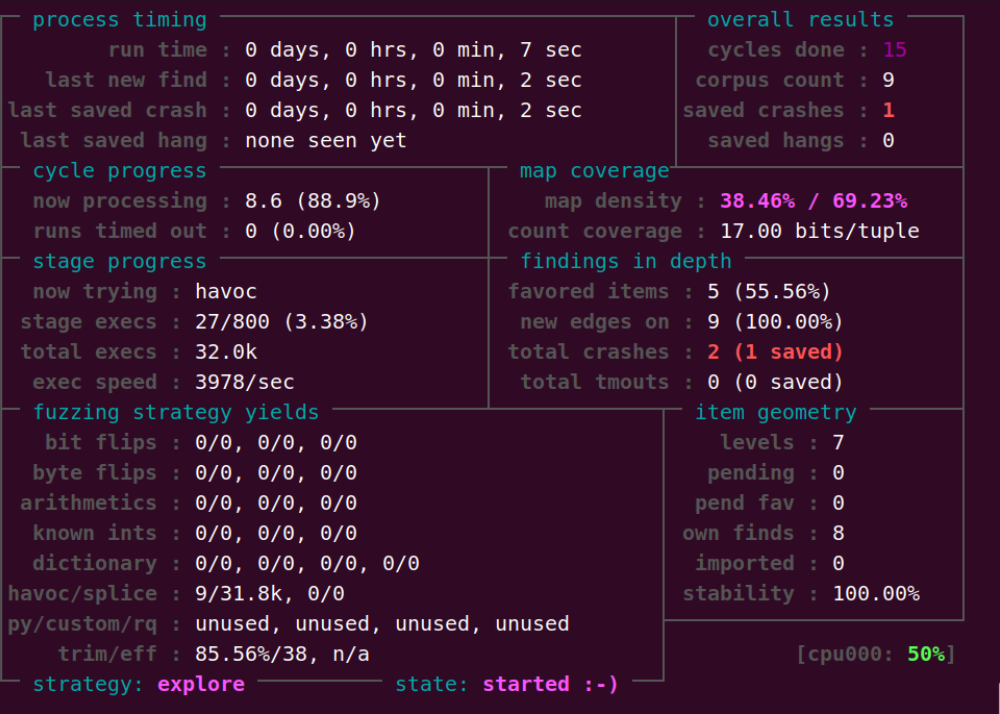
先看阶梯式的test_step的fuzzing结果,可以发现5s钟就获取crashes
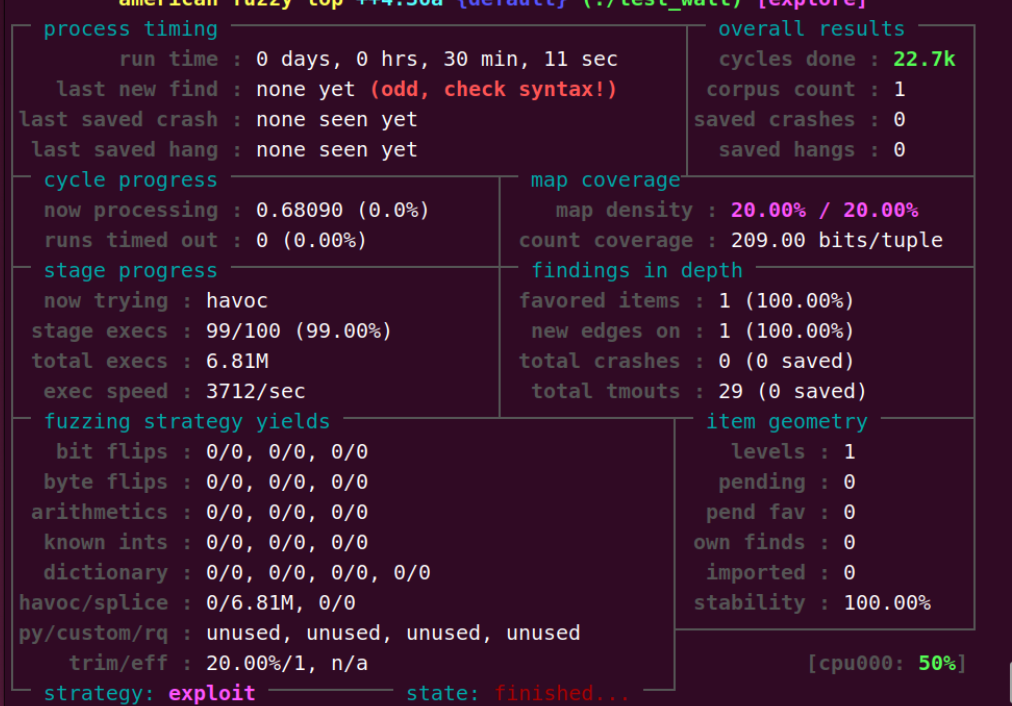
那么我们看看平墙式test_wall的fuzzing结果,等了半个小时,探索进度始终卡在20%/20%,什么都么有发现
3rd. 阶梯式 vs 平墙式
为什么会出现这种情况?
阶梯式(逐步反馈)
if (buf[0] == 'A')
    if (buf[1] == 'F')
        if (buf[2] == 'L')
            if (buf[3] == '+')
                if (buf[4] == '+')
                    __builtin_trap();
特点:
- 每匹配一个字符,就进入一个 新的基本块(新边)
- AFL 能感知 部分进展,逐步保留接近目标的变异
- 有覆盖率反馈
平墙式(一棒子打死)
if (memcmp(buf, "AFL++", 5) == 0)
    __builtin_trap();
特点:
- 只有 完全匹配 5 字节才触发崩溃
- 匹配 0~4 字节时,没有任何新边产生
- AFL 无法区分 “接近目标” 和 “完全无关” 的输入
- 无覆盖率反馈,纯靠随机碰撞
| 对比维度 | 阶梯式 if 嵌套 | 平墙式 memcmp |
|---|---|---|
| 覆盖率反馈 | ✅ 每步都有新边 | ❌ 完全无反馈 |
| 变异方向性 | ✅ 有明确引导 | ❌ 纯随机碰撞 |
| 发现时间 | 5秒 | >30分钟(未找到) |
| 执行效率 | 15次找到 | 681万次无果 |
| AFL 状态 | 活跃探索 | 绝望 finished |
AFL变异策略的底层逻辑(为什么平墙式会“退化为随机测试”)
- 阶梯式:每猜对一个字符,程序进入新基本块,AFL++通过“新边覆盖”奖励该输入,并基于此变异(如bitflip、arith等),形成“反馈循环”。
- 平墙式:
memcmp只有“全对/全错”两种结果,AFL++无法区分“接近目标”和“完全无关”的输入。此时,AFL++的变异策略(如havoc、splice)会变成“盲猜”,因为没有任何中间信号引导变异方向。
那这是否意味着本次实验失败了呢?
并非,恰恰证明了 覆盖率引导是 AFL 的灵魂。在当前的极端案例中程序设计为"平墙式"判断时,AFL 退化为纯粹的随机测试,效率足足暴跌了45万倍。
阶梯式通过‘新边覆盖’形成反馈循环,AFL++能基于历史输入变异(如bitflip、arith),逐步逼近目标;而平墙式因缺乏中间信号,AFL++的变异策略(如havoc、splice)退化为‘盲猜’。这解释了为什么真实漏洞中,
memcmp等‘全有或全无’的检查是fuzzing的常见障碍——AFL++为此开发了CmpLog、Redqueen等技术,通过记录比较函数的输入/输出,生成更精准的种子,从而绕过这类障碍。
4th. 深入:为什么平墙式让 AFL “失明”?
AFL 的核心假设:变异输入如果触发了新代码路径,就保留下来继续变异。
平墙式 memcmp 打破了这一假设:
输入 “test” → memcmp 失败 → 路径 A → 无新边 → 丢弃
输入 “Axxxx” → memcmp 失败 → 路径 A → 无新边 → 丢弃
输入 “AFxxx” → memcmp 失败 → 路径 A → 无新边 → 丢弃
输入 “AFL++” → memcmp 成功 → 路径 B → 崩溃!
从 AFL 的视角,前三种输入完全无法区分——它们都走同一条路径,都被视为"无价值"。
概率计算:
- 假设字符集为 62 个(
[a-zA-Z0-9]) - 随机生成
"AFL++"的概率:(1/62)^5 ≈ 1/9 亿 - 以 3712 execs/sec 的速度,期望时间 ≈ 67 小时
而阶梯式通过中间反馈,将问题分解为 5 个独立子问题,每个只需 (1/62) 概率,整体复杂度从指数级降为线性级。
- 本次实验使用的是“空种子”(
echo "test" > in/seed.txt),若种子包含部分字符(如"A"、"AF"),平墙式的表现是否会改善? - AFL++的配置参数(如
-t超时时间、-m内存限制)是否会影响结果?比如,延长超时时间是否会增加平墙式的发现概率?
为什么这个实验很重要?
真实软件中大量存在"平墙式"判断:
- 文件头魔数检查:
if (memcmp(header, "PNG", 3) != 0) return ERROR; - 协议版本校验:
if (version != PROTO_VER) return FAIL; - 校验和验证:
if (crc32(buf) != expected) return CORRUPT;
没有覆盖率反馈时,AFL 需要暴力枚举 2^32 种可能才能通过 CRC 校验。而阶梯式结构(如分步解析文件头)则能让 AFL 逐步深入。
那么面对平墙式
memcmp,AFL++ 就束手无策了吗?
并非。AFL++ 的 CmpLog 模式(AFL_LLVM_CMPLOG=1)专门解决这类问题:
- 在编译期 hook 所有比较指令(
memcmp、strcmp等) - 运行时捕获比较操作数,智能变异输入以绕过检查
这将是我们后面的内容…(敬请期待~)
04 崩溃分析
直接用刚刚test_step的崩溃文件
cd ~/afl_test

# 确保有崩溃文件
ls step_out/default/crashes/
启动gdb进行基础分析
# 启动 GDB
gdb ./test_step

# 运行到崩溃
(gdb) run step_out/default/crashes/id:000000*

# 查看崩溃信息
(gdb) info registers    # 寄存器状态
(gdb) bt                # 调用栈回溯
(gdb) x/10i $pc         # 崩溃处附近指令
显示结果(部分):
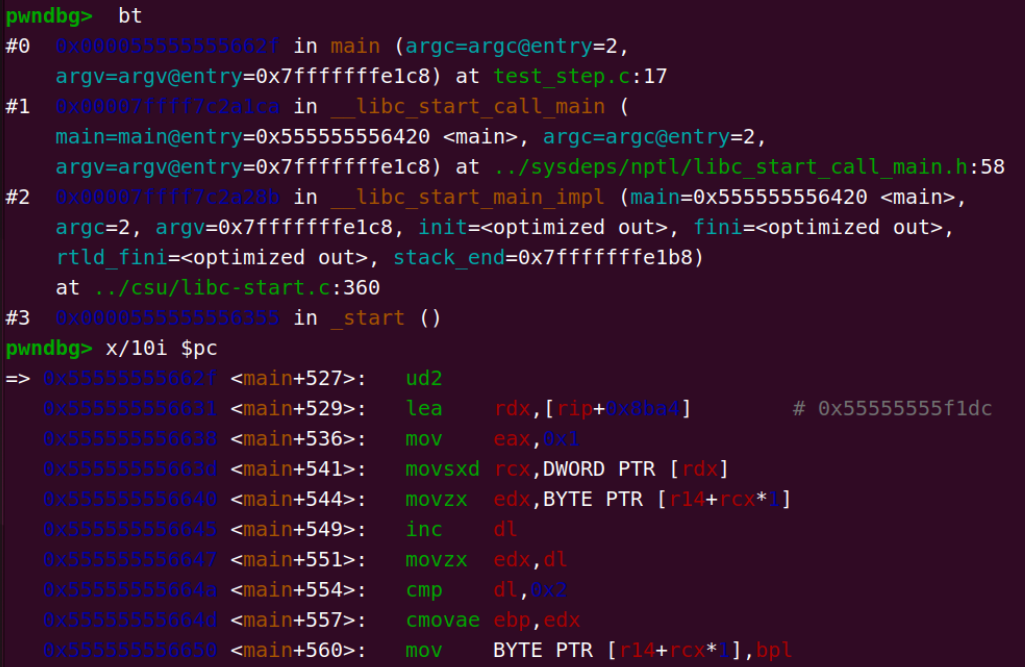
可以看的最新的指令指向ud2触发的崩溃
ud2 是 x86 架构的故意未定义指令,专门用于触发崩溃。
| 特性 | 说明 |
|---|---|
| 全称 | Undefined Instruction(未定义指令) |
| 操作码 | 0F 0B(2字节) |
| 作用 | 强制产生 #UD(Undefined Opcode)异常 |
| 结果 | SIGILL(Illegal Instruction)信号 |
| 用途 | 编译器插入的"安全崩溃点" |
GDB 分析显示崩溃点为 ud2 指令,这是 x86 的故意未定义指令,由编译器生成以触发 SIGILL。虽然源代码使用 __builtin_trap()(通常生成 int3),但优化器可能选择 ud2 作为更明确的"安全崩溃"标记。这验证了崩溃是程序设计的可控终止,而非内存破坏导致的非法执行。
以及,如果有师傅还记得第一篇文章中查看和验证崩溃的方式
❯ xxd step_out/default/crashes/id:000000*
00000000: 4146 4c2b 2b10 8060                      AFL++..`
❯ ./test_step step_out/default/crashes/id:000000*
[1]    808657 illegal hardware instruction  ./test_step
那可能也会有一定的疑惑:
- 为什么xxd能查看崩溃时的输入信息?
- 为什么这样可以验证崩溃查看信息?
首先,xxd 是一个十六进制转储工具,可以把任意文件以十六进制和 ASCII 形式显示出来。
其次,AFL 保存的崩溃文件就是普通的二进制文件,本质上是触发崩溃的原始输入数据。
实际上:
./test_step crash_file
#     ↑程序        ↑输入数据(被 xxd 查看的就是这个)
相当于把crash_file作为参数输入给了程序,那程序当然会报和当时一样的错
总的来说,xxd 是十六进制转储工具,用于查看 AFL 保存的崩溃文件(原始输入数据)的字节内容,确认触发崩溃的具体输入是否为预期的 "AFL++" 或变异版本。
05 总结
本文从三个层面深入探索了 AFL++ 的核心机制,完成了从底层原理到实际应用的闭环学习:
插桩底层:解码覆盖率追踪的汇编实现
通过 IDA 反编译对比 afl-cc 与 gcc 编译的二进制,观察到 LLVM SanitizerCoverage 的内联插桩机制——__afl_area_ptr 指向共享内存位图,guard 变量标识代码边,配合 inc + cmovb 指令实现 NeverZero 溢出保护。这揭示了 AFL++ 如何在零函数调用开销下,完成边覆盖率的精确追踪。
反馈机制:验证覆盖率引导是 AFL 的灵魂
通过"阶梯式"与"平墙式"代码的对比实验,量化了覆盖率反馈对变异效率的决定性影响。阶梯式因每步产生新边、形成反馈循环,5 秒即发现崩溃;平墙式因 memcmp 全有或全无的特性,退化为随机盲猜,30 分钟 681 万次执行无果——效率差距达 45 万倍。这一结果解释了真实漏洞中魔数检查、CRC 校验等"平墙式"逻辑为何是 fuzzing 噩梦。
崩溃分析:建立从发现到理解的闭环
借助 GDB 定位崩溃点为 ud2 指令(SIGILL),区分了编译器生成的安全崩溃与内存错误导致的非法执行;通过 xxd 验证崩溃文件本质是原始输入,完成了"触发崩溃→根因定位→输入重现"的完整分析流程。
下一篇将探索 AFL++ 的 ASAN/MSAN/UBSAN 集成,理解内存错误检测与覆盖率引导的协同工作机制,敬请期待。