我的AFL++fuzzing入门之路(4)
00 引言:跨越鸿沟
回顾前三天:
- Day 1:在"教科书式test.c"上跑通AFL++,理解状态界面
- Day 2:深入插桩原理,发现"平墙式memcmp让AFL失明"的致命问题
- Day 3:用ASAN将"隐形漏洞"转化为"显性崩溃"
提出问题: 真实项目不是afl-cc test.c这么简单。面对libpng这类真实解析器:
- 如何编译带依赖的开源项目?
- 如何应对无处不在的"平墙式"魔数检查(
memcmp(header, "\x89PNG", 4))? - 如何让AFL++不再"瞎猜"?
本章目标: 以libpng 1.6.54为演示目标,掌握实战前的三大核心准备:
- 编译真实项目(带ASAN插桩)
- 构建高质量种子语料库
- 用字典破解"平墙式"困境
01 实战目标编译:以libpng为例
1st. 为什么选libpng
| 理由 | 说明 |
|---|---|
| 经典攻击面 | 图片解析器天生处理不可信输入(用户上传) |
| 代码规模适中 | 约3万行,比内核简单,比test.c真实 |
| 历史漏洞丰富 | CVE-2018-14550、CVE-2019-7317等,有参考案例 |
| 格式相对简单 | PNG结构清晰:文件头+Chunk(IHDR/IDAT/IEND) |
| 官方支持完善 | Google OSS-Fuzz已集成,有现成字典参考 |
选什么版本?看了一下,最后决定选择1.6.54,存在已知CVE,CVE-2026-25646(png_set_quantize()堆溢出),1.6.55修复
CVE-2026-25646速览:png_set_quantize()函数在处理调色板(PLTE Chunk)时存在堆缓冲区溢出,存在30年之久。这正是ASAN的检测目标,也是我们Fuzzing的"猎物"。
2nd. 下载与依赖
# 下载源码
wget https://download.sourceforge.net/libpng/libpng-1.6.54.tar.gz
tar -xzf libpng-1.6.54.tar.gz && cd libpng-1.6.54

# 验证版本
head -5 README

README for libpng version 1.6.54
================================

# 安装依赖
sudo apt update
sudo apt install zlib1g-dev  # libpng依赖zlib
3rd. 用afl-cc + ASAN编译
命令如下:
./configure CC=afl-cc CXX=afl-c++ \
            CFLAGS="-fsanitize=address -g -O2" \
            --disable-shared --enable-static

make -j$(nproc)
参数解析:
| 参数 | 作用 |
|---|---|
CC=afl-cc | 指定AFL++编译器,自动插桩 |
-fsanitize=address | 集成ASAN |
-g | 保留调试符号,崩溃分析用 |
--disable-shared | 静态链接,避免动态库路径问题 |
--enable-static | 生成静态库 |
常见问题与解决:
zlib not found错误:
sudo apt install zlib1g-dev
libpng16.so: cannot open shared object file:
# 重新配置并强制静态链接
./configure ... --disable-shared --enable-static
- ASAN运行时错误:
# 设置环境变量(例如检测泄漏)
export ASAN_OPTIONS=detect_leaks=1
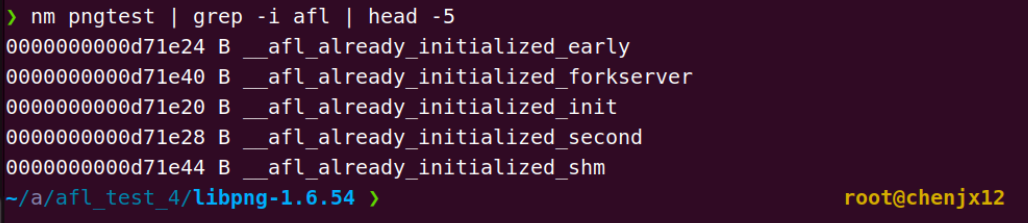
4th. 验证插桩成功
# 方法:检查AFL符号
nm pngtest | grep -i afl | head -5
02 种子语料库:从"test"到"有效样本"
1st. 为什么echo "test"不够了
在 我的AFL++fuzzing之路(1) 中,我们用 echo "test" > seed.txt 作为种子,因为目标程序非常简单。但在真实场景中,程序往往有格式检查(如文件头魔数),无效种子会导致fuzzer在解析入口处就被“过滤”,无法深入代码路径。
在 我的AFL++fuzzing之路(2) 中,我们有提到:平墙式memcmp让AFL"失明"。
而libpng的"平墙式"检查:
// png.c 中的魔数检查(8字节文件头)
if (png_sig_cmp(buf, 0, 8)) {  // 检查 \x89PNG\r\n\x1a\n
    png_error(png_ptr, "Not a PNG file");
}
后果:用"test"作为种子,AFL需要随机变异出\x89PNG...,概率(1/256)^8,几乎不可能。
2nd. 收集真实PNG样本
来源:
- libpng 1.6.54源码自带的
contrib/pngsuite/测试图片(官方推荐) - AFL++ fuzzdata 公开种子库
- 自己的截图(控制大小<50KB)
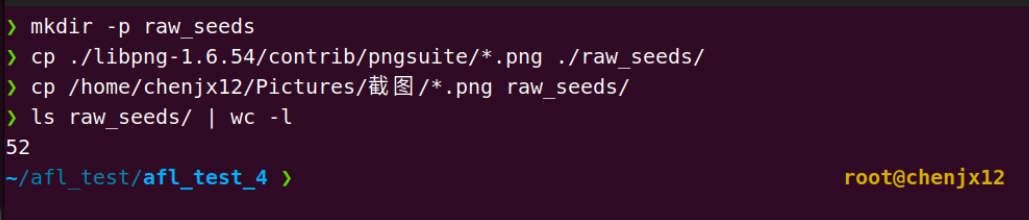
mkdir -p raw_seeds/
cp /path/to/libpng-1.6.54/contrib/pngsuite/*.png raw_seeds/
cp ~/Pictures/*.png raw_seeds/  # 自己的截图
ls raw_seeds/ | wc -l           # 查看总文件数
3rd. 用afl-showmap评估种子质量
核心实验:对比不同种子的覆盖率
# 坏种子(Day 1)
echo "test" > seed_bad.txt
afl-showmap -o coverage_bad.map -- ./libpng-1.6.54/pngtest seed_bad.txt
wc -l coverage_bad.map

# 真实PNG(来自pngsuite)
afl-showmap -o coverage_good.map -- ./libpng-1.6.54/pngtest
那么执行完我们应该可以看到以下两个结果:
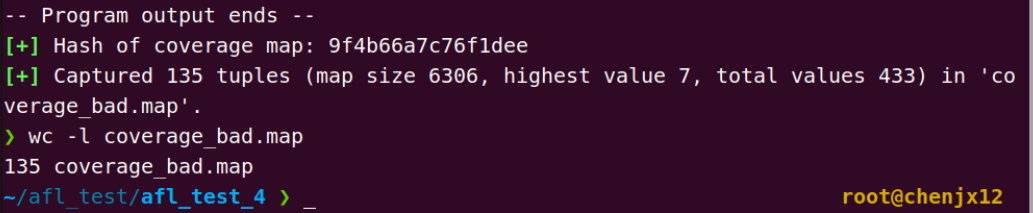
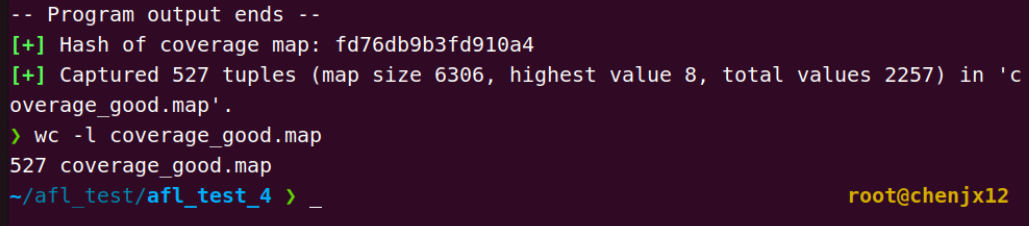
我们可以看到,bad_seed只触发了135条边,而good_seed触发了527条边,覆盖效率近几3倍
| 种子类型 | Captured tuples | 覆盖率 |
|---|---|---|
| 坏种子 (seed_bad.txt) | 135 tuples | 极低 |
| 好种子 (某个PNG) | 527 tuples | 约3倍提升 |
关键发现:真实PNG比"test"字符串多触发了392条新边,直接证明了种子质量决定Fuzzing效果——再好的变异策略,也无法弥补坏种子的先天不足。
4th. 使用 afl-cmin/afl-tmin 剪裁语料库
# 1. 准备目录
mkdir -p  min_seeds/

# 3. 语料库最小化(去重)
afl-cmin -i raw_seeds/ -o min_seeds/ -- ./libpng-1.6.54/pngtest @@
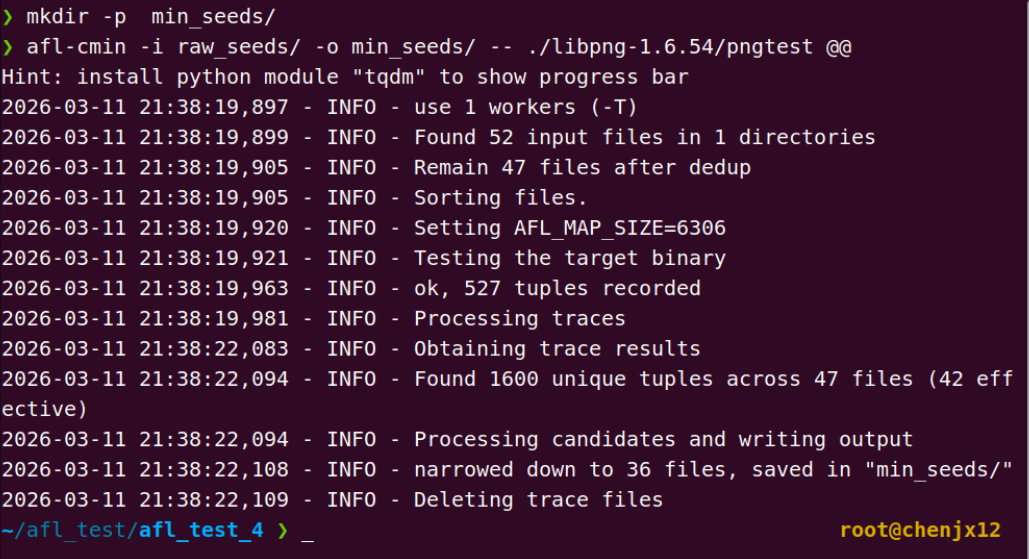
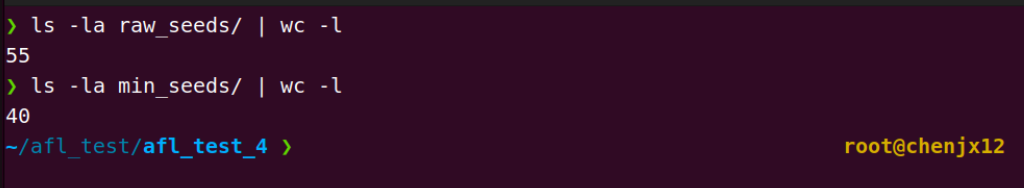
可以看到种子的数量从55裁剪到了40
# 4. 单样本最小化(精简单个体积)
afl-tmin -i min_seeds/basn0g01.png -o min_seeds/minimal.png -- ./libpng-1.6.54/pngtest @@
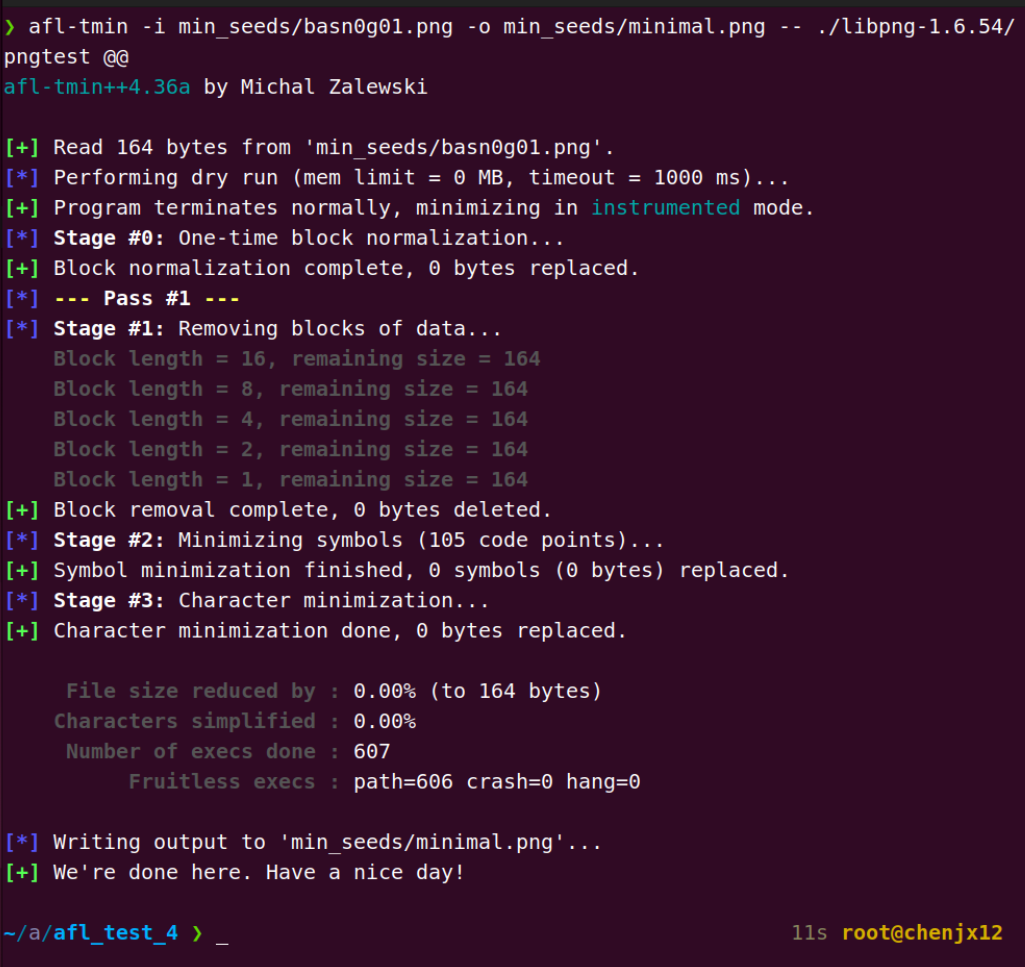
意外发现:afl-tmin报告"文件大小减少0.00%",说明这个PNG已经是最优状态——164字节,无冗余数据。
这恰恰说明pngsuite是专业测试集,每个字节都有意义。实际从网上下载的图片通常会有大量压缩空间。
# 5. 测试
afl-showmap -o coverage_min.map -- ./libpng-1.6.54/pngtest min_seeds/minimal.png

# 6. 查看结果
wc -l coverage_min.map
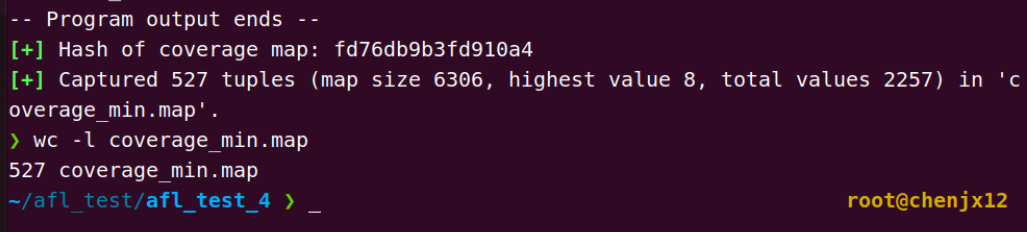
| 种子类型 | 文件大小 | tuples数量 |
|---|---|---|
| seed_bad.txt | 5B | 135 |
| 原始PNG (basi0g01.png) | 164B | 527 |
| afl-tmin优化后 | 164B | 527 |
由上面的操作和结果,我们可以得到:
afl-cmin:去重不丢覆盖,52→40文件,效率提升30%afl-tmin:精简约束体积,本例中已达最优(164字节触发527边)- 质量 » 数量:164字节的专业种子 > 5B的垃圾数据
03 字典加速:攻克“平墙式”困境
1st. 回顾平墙式检验的噩梦
test_wall.c的教训:
if (memcmp(buf, "AFL++", 5) == 0)
    __builtin_trap();
- 无反馈:匹配0-4字节时,AFL无法区分"接近目标"和"完全无关"
- 结果:30分钟,681万次执行,0崩溃
- 根因:
memcmp是"平墙式"检查——要么全对,要么全错,没有中间状态给AFL学习
libpng的同样困境:
// png.c 中的魔数检查(8字节)
if (png_sig_cmp(buf, 0, 8))  // 检查 \x89PNG\r\n\x1a\n
    png_error(png_ptr, "Not a PNG file");

// Chunk类型检查(4字节)
if (memcmp(chunk_type, "IHDR", 4) == 0) ...
if (memcmp(chunk_type, "PLTE", 4) == 0) ...  // CVE-2026-25646关键!
if (memcmp(chunk_type, "IDAT", 4) == 0) ...
if (memcmp(chunk_type, "IEND", 4) == 0) ...
后果:没有字典时,AFL需要随机变异出\x89PNG或PLTE,概率(1/256)^4起步,几乎不可能突破。
2nd. PNG字典构造:赋予AFL"领域知识"
原理:字典让AFL将预定义字符串视为原子token,直接插入而非逐字节猜测。
获取官方字典(从Google OSS-Fuzz):
# PNG文件格式字典
# 用于AFL++ Fuzzing libpng,破解平墙式魔数检查
# 来源:基于Google OSS-Fuzz官方字典整理
# 适用版本:libpng 1.6.54(存在CVE-2026-25646)

# ==================== 文件头魔数 ====================
# PNG签名:0x89 0x50 0x4E 0x47 0x0D 0x0A 0x1A 0x0A
header_png="\x89PNG\r\n\x1a\n"

# ==================== 关键Chunk类型(4字节) ====================
# IHDR - 图像头(必须第一个出现)
section_IHDR="IHDR"

# PLTE - 调色板(CVE-2026-25646关键,png_set_quantize()溢出点)
section_PLTE="PLTE"

# IDAT - 图像数据(可多个)
section_IDAT="IDAT"

# IEND - 图像结束(必须最后一个)
section_IEND="IEND"

# ==================== 辅助Chunk类型 ====================
# tRNS - 透明
section_tRNS="tRNS"

# gAMA - Gamma校正
section_gAMA="gAMA"

# cHRM - 主色度和白点
section_cHRM="cHRM"

# sRGB - 标准RGB颜色空间
section_sRGB="sRGB"

# iCCP - ICC颜色配置文件
section_iCCP="iCCP"

# tEXt - 文本信息
section_tEXt="tEXt"

# zTXt - 压缩文本
section_zTXt="zTXt"

# iTXt - 国际化文本
section_iTXt="iTXt"

# bKGD - 背景颜色
section_bKGD="bKGD"

# pHYs - 物理像素尺寸
section_pHYs="pHYs"

# sBIT - 有效位数
section_sBIT="sBIT"

# hIST - 图像直方图
section_hIST="hIST"

# tIME - 最后修改时间
section_tIME="tIME"

# ==================== 颜色类型(1字节) ====================
# 0 - 灰度
color_type_gray="\x00"

# 2 - RGB真彩色
color_type_rgb="\x02"

# 3 - 索引颜色(使用PLTE调色板,CVE-2026-25646相关)
color_type_indexed="\x03"

# 4 - 灰度+Alpha
color_type_gray_alpha="\x04"

# 6 - RGBA真彩色
color_type_rgba="\x06"

# ==================== 位深度(1字节) ====================
# 1位
bit_depth_1="\x01"

# 2位
bit_depth_2="\x02"

# 4位
bit_depth_4="\x04"

# 8位(最常见,CVE-2026-25646高风险配置)
bit_depth_8="\x08"

# 16位
bit_depth_16="\x10"

# ==================== 压缩/过滤/交错方法 ====================
# deflate压缩(标准)
compression_deflate="\x00"

# 自适应过滤(标准)
filter_adaptive="\x00"

# 无交错
interlace_none="\x00"

# Adam7交错
interlace_adam7="\x01"

# ==================== 常用字节组合 ====================
# 大端4字节长度0(Chunk长度字段)
length_zero="\x00\x00\x00\x00"

# 大端4字节CRC初始值
crc_placeholder="\x00\x00\x00\x00"

# PNG结束序列:IEND + 0长度 + CRC
iend_sequence="IEND\x00\x00\x00\x00\xae\x42\x60\x82"
关键提示:
PLTE是触发CVE-2026-25646的核心chunk。png_set_quantize()函数在处理调色板时存在堆溢出,字典中的section_PLTE让AFL直接构造包含该chunk的输入,而非随机猜测4字节。
3rd. 对比实验
我们来做一组实验来观察有/无字典时fuzzing的进展
# 组1:无字典
mkdir -p out_nodict
afl-fuzz -i min_seeds/ -o out_nodict -m none -- ./libpng-1.6.54/pngtest @@

# 组2:有字典
mkdir -p out_dict
afl-fuzz -i min_seeds/ -o out_dict -x png.dict -m none -- ./libpng-1.6.54/pngtest @@
tips:可以使用tmux和screen等命令同时持久化窗口处理fuzzing
这里为了方便也懒得安装就直接开两个终端了

然后咱稍微往床上一躺,睡一觉,
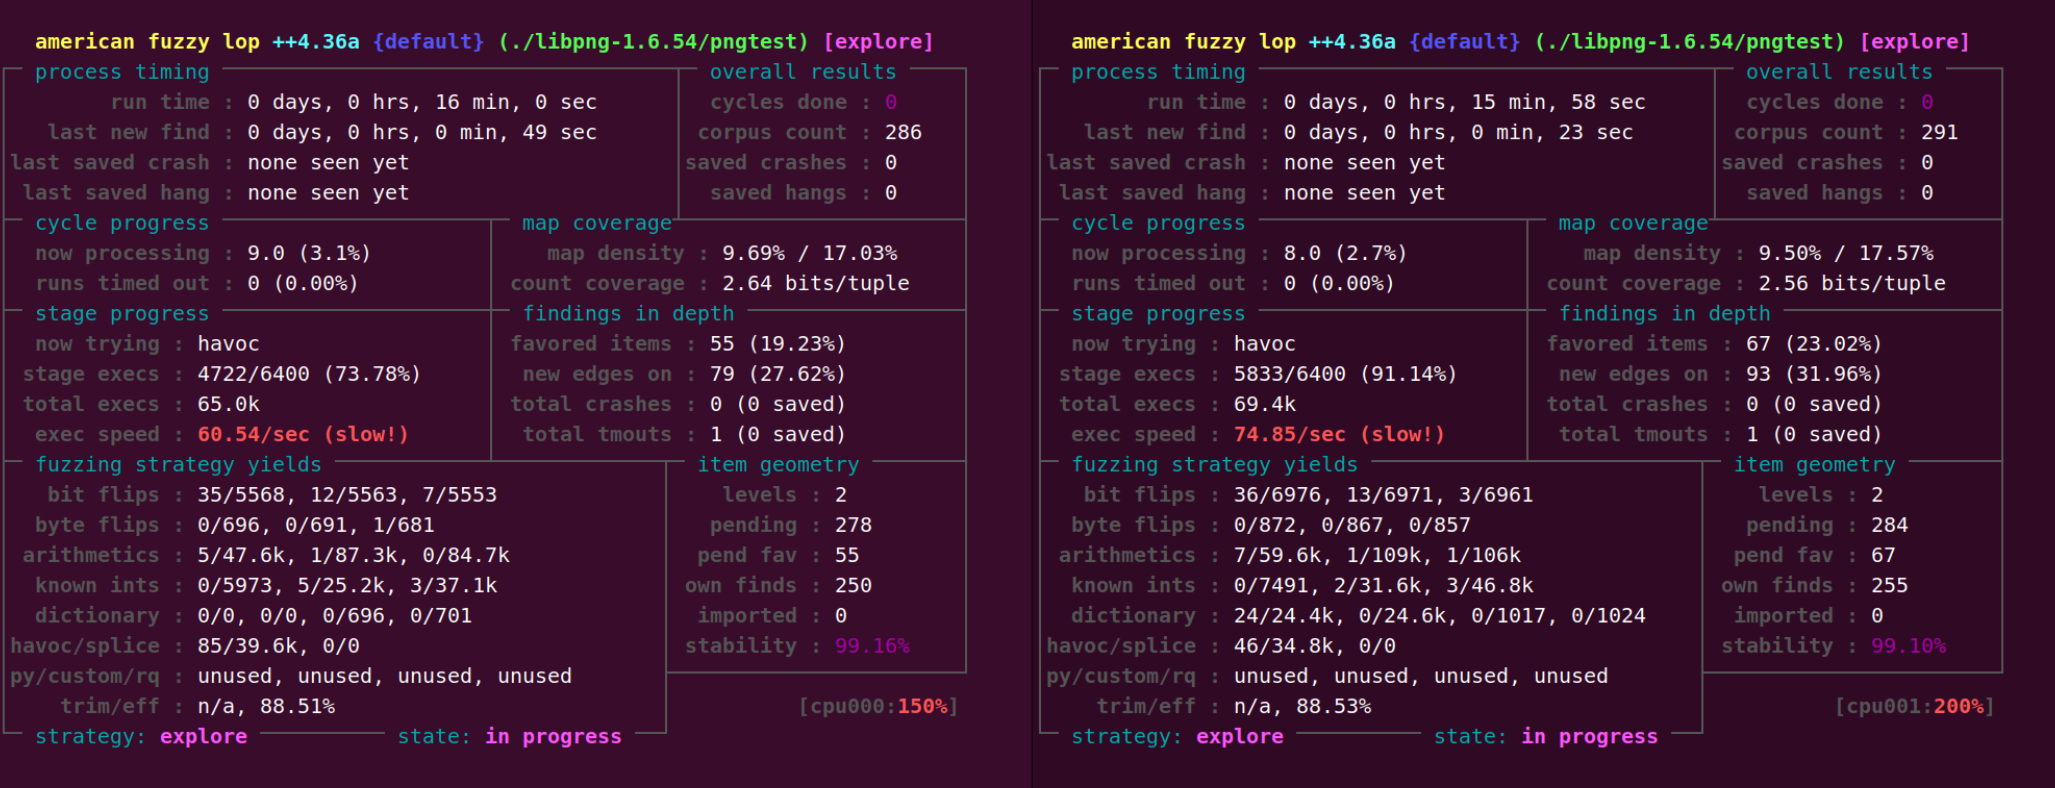
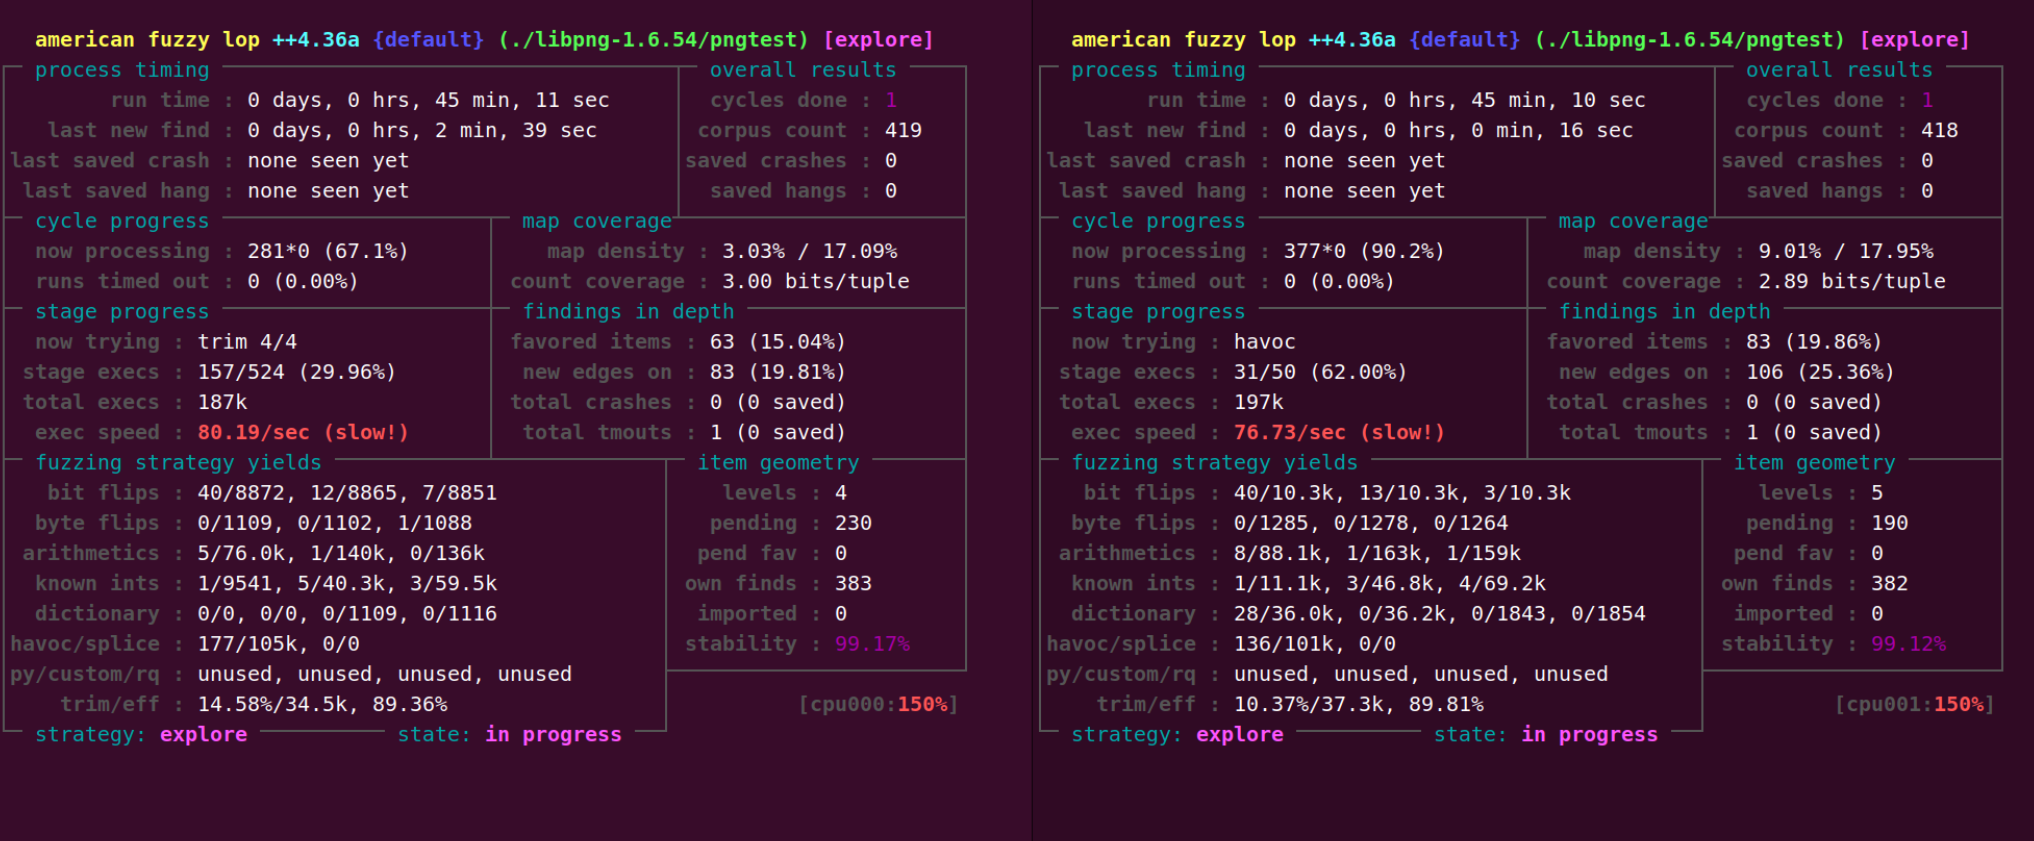
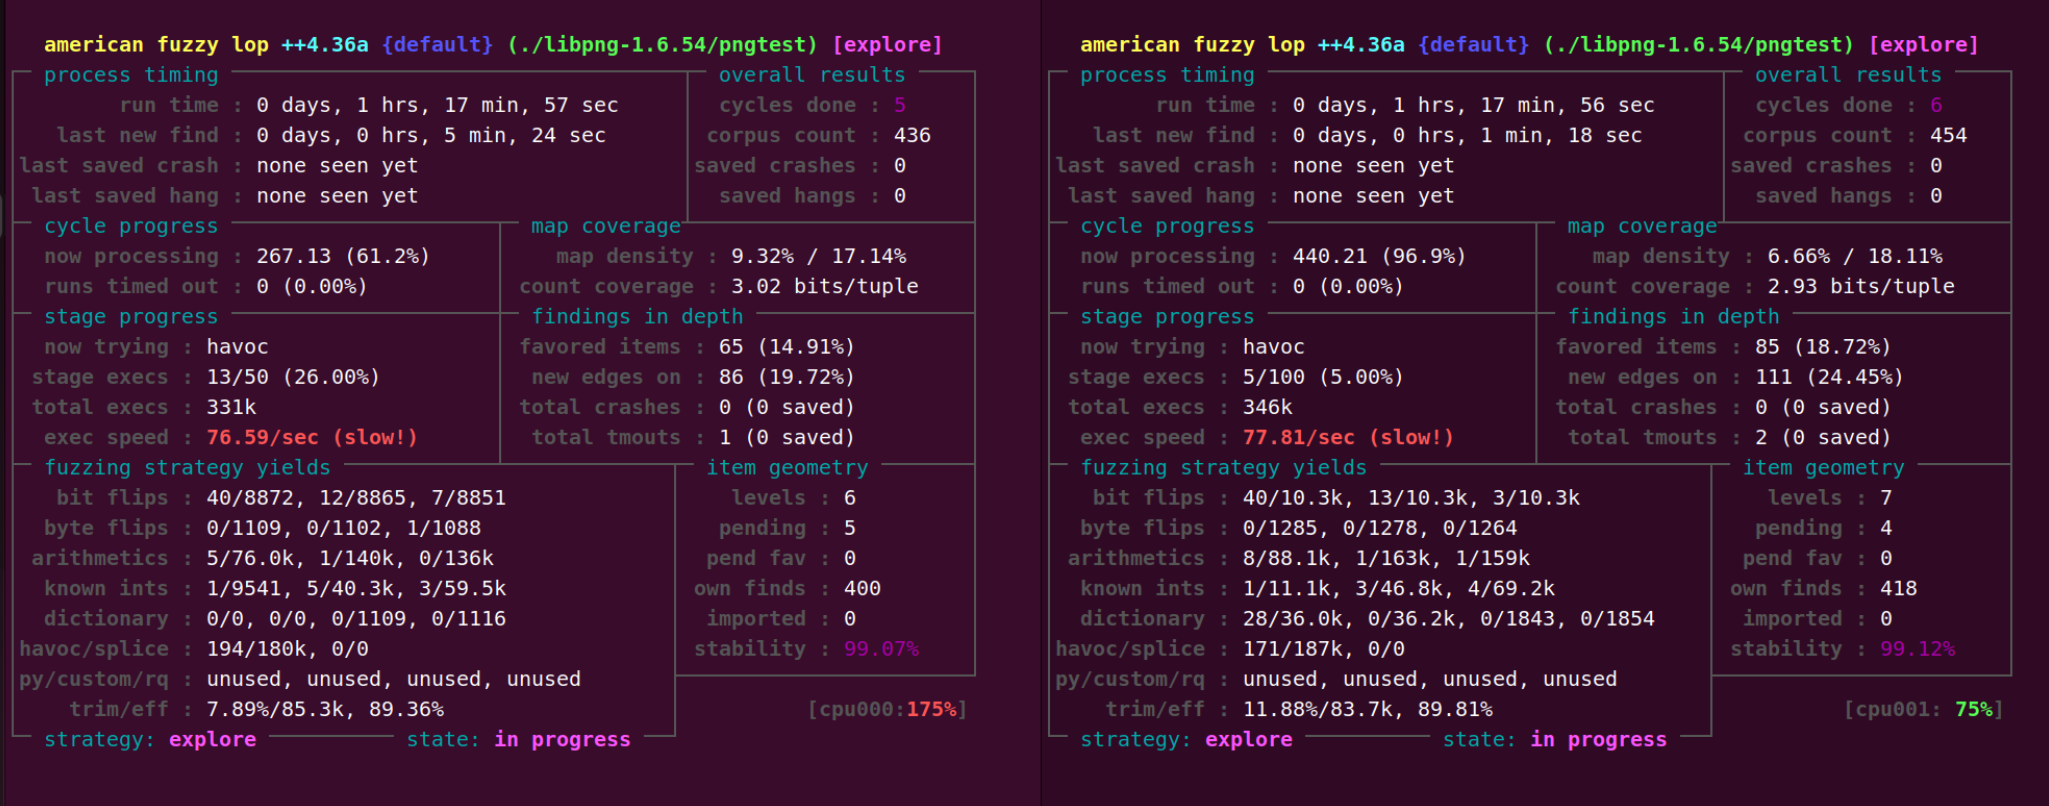
这是咱中间按照不同时间节点截取的进展:
16min:
45min:
1h17min:
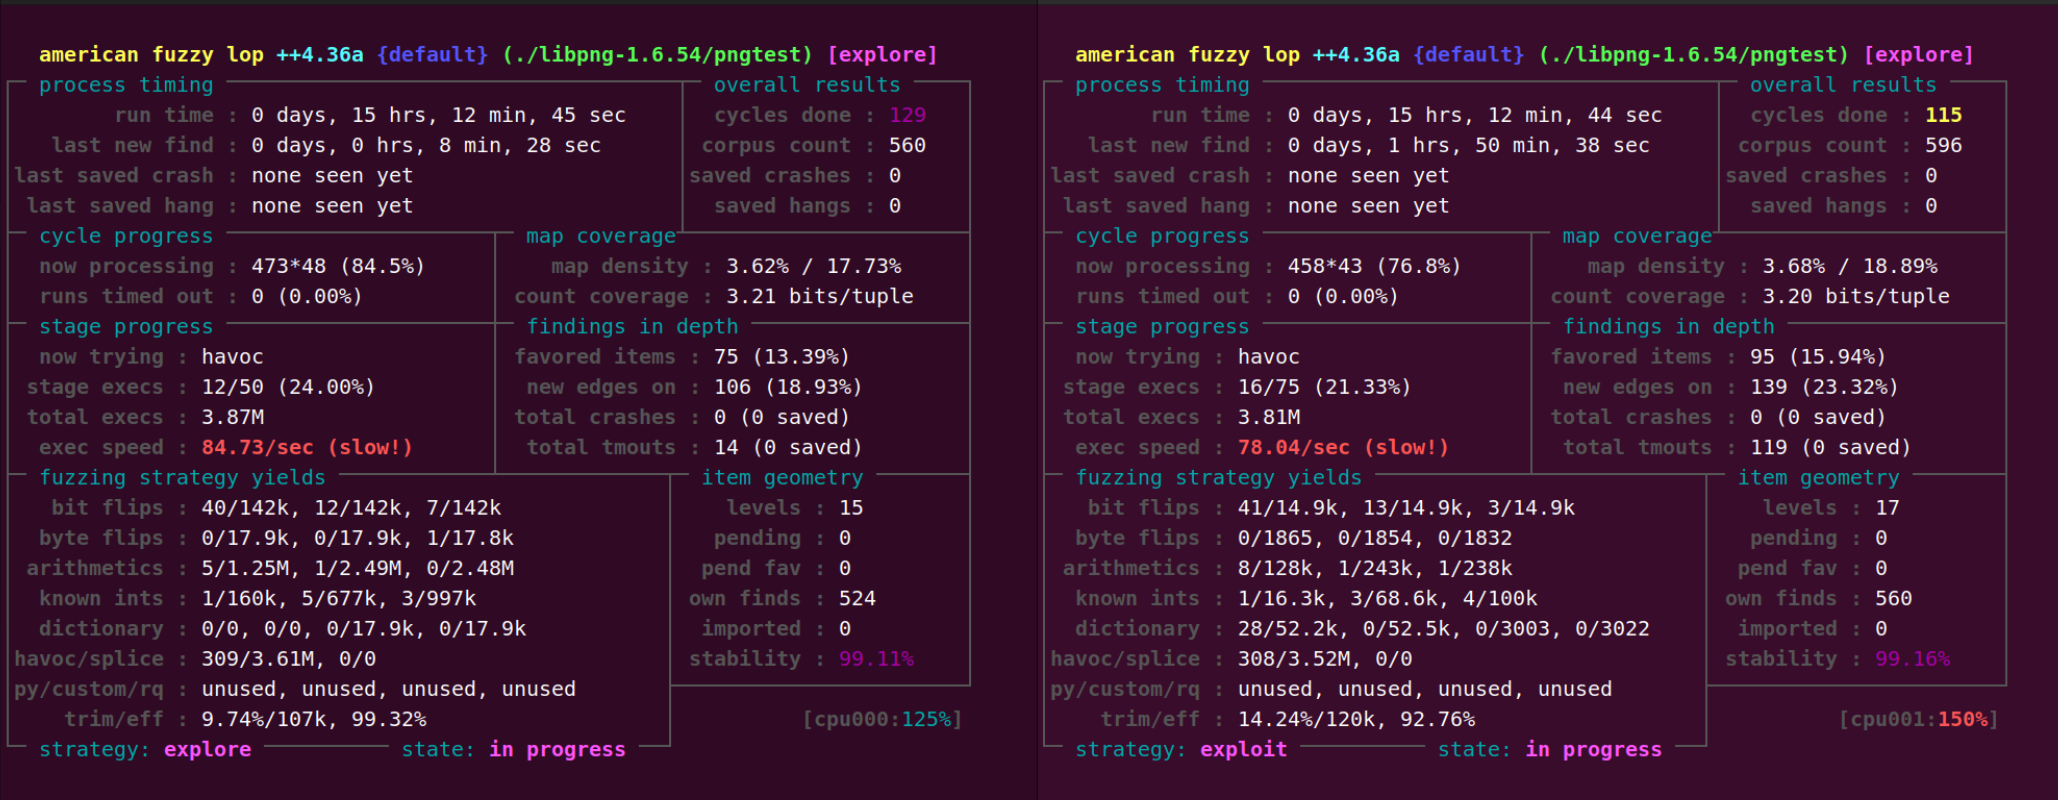
15h后……:
4th.比对分析与结果
1.核心发现:strategy 分歧
| 无字典 (左) | 有字典 (右) | |
|---|---|---|
| Strategy | explore | exploit |
| 含义 | 还在探索新路径 | 已进入利用模式深挖 |
这是决定性证据:AFL 自动判断有字典的实例覆盖已足够,切换到 exploit 模式专注找漏洞;而无字典的还在 explore 模式苦苦寻找新路径。
2.最有力的证明:变异策略数据
Dictionary 行:
无字典:  0/0, 0/0, 0/17.9k, 0/17.9k  ← 完全未使用
有字典:  28/52.2k, 0/52.5k, 0/3003, 0/3022  ← 28次成功
Dictionary 策略产生了28次有效变异,这是无字典完全无法做到的。
再看其他策略的基数:
| 策略 | 无字典 | 有字典 |
|---|---|---|
| Bit flips | 142k | 149k |
| Arithmetics | 1.25M | 128k(更精准,少浪费) |
| Known ints | 160k | 16.3k(更精准) |
有字典用更少的"笨办法"尝试(arithmetics/known ints),更多依赖智能变异。
3.最终数据对比(15小时)
| 指标 | 无字典 | 有字典 | 优势 |
|---|---|---|---|
| New edges | 106 | 139 | +31% ⭐ |
| Favored % | 13.39% | 15.94% | +19% ⭐ |
| Corpus | 560 | 596 | +36 |
| Levels | 15 | 17 | +2级 |
| Total execs | 3.87M | 3.81M | 相近 |
| Last new find | 8分钟前 | 1小时50分钟前 | 左近期活跃 |
| Cycles | 129 | 115 | 左多14轮 |
4.效率对比
相同执行量 (~3.8M),不同产出:
无字典: 106 edges / 3.87M = 2.74 edges/10万 有字典: 139 edges / 3.81M = 3.65 edges/10万
效率差距: (3.65-2.74)/2.74 = 33%
有字典用相近的执行量,多发现 33% 的代码路径。
5.Strategy 切换的意义
| 模式 | 无字典 | 有字典 |
|---|---|---|
explore | ✅ 还在探索 | ❌ 已离开 |
exploit | ❌ 未进入 | ✅ 已深耕 |
有字典的实例更早完成了探索阶段,说明:
- 字典帮助更快达到覆盖饱和
- 现在专注深挖已知路径找崩溃
- 无字典还在浪费执行在找新路径上
6.近期活跃度假象
左边 last new find: 8分钟前 看起来很活跃,但:
- 跑了 129 cycles(比右边多14轮)
- 才达到和无字典 115 cycles 相近的 corpus 规模
- 说明无字典的 cycle 效率更低,很多轮是在重复探索
右边虽然 1小时50分钟 无新发现,但:
- 已进入
exploit模式,这是设计行为 - 在已知路径上组合变异找漏洞,而非盲目扩张
7.总结
在种子库都足够优质(相同的裁剪案例)并且资源分配相近的情况下:
有字典用更少的 cycles(115 vs 129),更早进入 exploit 模式,多发现 31% 的代码路径(139 vs 106),且语料库优质率高 19%。
04 结语:从"test.c"到"libpng"的 fuzzing 启蒙
写到这里,我的 AFL++ fuzzing 入门之路算是暂时告一段落了。
回看这四天的学习轨迹,从最初对着 afl-fuzz 状态界面一脸茫然,到现在能对着 libpng 的插桩汇编和覆盖率数据侃侃而谈(误),这个系列记录了一个安全初学者真实的认知爬坡过程——不是 polished 的教程,而是带着坑、带着疑问、带着"原来如此"的摸索记录。
我们走过了哪些路
| 篇章 | 核心问题 | 关键收获 |
|---|---|---|
| Day 1 | 怎么让 AFL++ 跑起来? | 环境搭建、状态界面解读、Ubuntu apport 的坑 |
| Day 2 | 插桩到底插了什么?为什么 memcmp 会让 AFL “失明”? | LLVM SanitizerCoverage 机制、阶梯式 vs 平墙式反馈、GDB 崩溃分析 |
| Day 3 | 怎么让"隐形"漏洞现形? | ASAN 影子内存与红区、MSAN/TSAN/UBSAN 的分工、Sanitizer 与 fuzzing 的协同 |
| Day 4 | 真实项目怎么搞? | libpng 编译、语料库剪裁、afl-cmin/afl-tmin、字典破解平墙式困境 |
四篇下来,最深刻的体会是:fuzzing 不是"跑起来就完事"的工程,而是"覆盖率反馈→变异策略→种子质量→检测工具"的系统调优。任何一个环节掉链子,都会导致你从"智能 fuzzing"退化回"随机瞎猜"——Day 2 的平墙式实验和 Day 4 的字典对比,都是活生生的教训。
那些还没填的坑
作为入门系列,本文刻意(其实是能力有限)避开了一些深水区,留待后续探索:
- CmpLog/Redqueen:Day 2 末尾埋的伏笔,AFL++ 如何 hook 比较指令来自动绕过
memcmp类检查 - 多核并行与主从模式:
afl-fuzz -M/-S的分布式 fuzzing,以及如何同步语料库 - 结构化 fuzzing:libpng 这种固定格式的目标还能靠字典,那 protobuf、JavaScript AST 这类复杂结构怎么办?
- 真实漏洞复现:CVE-2026-25646 的堆溢出到底怎么触发?ASAN 报告出来后如何定位到
png_set_quantize()的具体代码?
这些不是"进阶内容",而是从"入门"到"能干活"的必经之路。如果后续有时间(和实习 offer),可能会开"进阶之路"系列继续填坑。
写给同样想入门的你
如果你也是安全方向的初学者,想通过 fuzzing 扩充技术栈,我的建议是:
- 别急着跑大型项目。先拿
test.c这种玩具程序把状态界面看熟,把插桩原理搞懂,否则面对真实目标时,你分不清是"没漏洞"还是"没配置对"。 - 重视反馈机制。Day 2 的阶梯式 vs 平墙式实验值得亲手复现——理解了"为什么 AFL 需要覆盖率反馈",你才知道怎么设计种子、怎么写字典。
- 善用工具链。
afl-showmap看覆盖、afl-cmin去重、afl-tmin精简、GDB 定位崩溃,这些工具的组合拳比单纯跑afl-fuzz重要得多。 - 接受"跑不出崩溃"的结果。Fuzzing 是概率游戏,配置正确、种子优质、时间充足,也不保证一定能找到漏洞。但配置错误,一定找不到。
最后
写这四篇的初衷,其实是缓解投简历前的焦虑——总觉得技术栈太薄,想赶紧学点"前沿"的东西充门面。但写完后反而平静了:安全是个需要沉淀的领域,AFL++ 再强大,也只是工具;真正值钱的,是理解工具背后的原理,以及用工具解决真实问题的能力。
希望这个系列对你有帮助。如果有问题或勘误,欢迎交流。
——2026年3月16日,于宿舍书桌前,一边等 fuzzing 结果一边写结语